变装
Skull Cap 反差变装视频
用一张照片制作 10 秒桌前自拍变装:亮场搞怪开头,遮镜转场后换成黑色连帽衫和紧身帽造型。
上传你的照片
使用一张清晰的成年人照片,正对镜头,脸部完整可见。
输出规格
无订阅10 积分每条视频
MP4已上传 0/1
每张照片仅一人,正面清晰的人像效果最好。支持 JPG、PNG、WebP,单张不超过 10MB。
什么是 Skull Cap 反差变装视频 潮流?
这个片段的玩法、格式,以及它为什么持续刷屏。
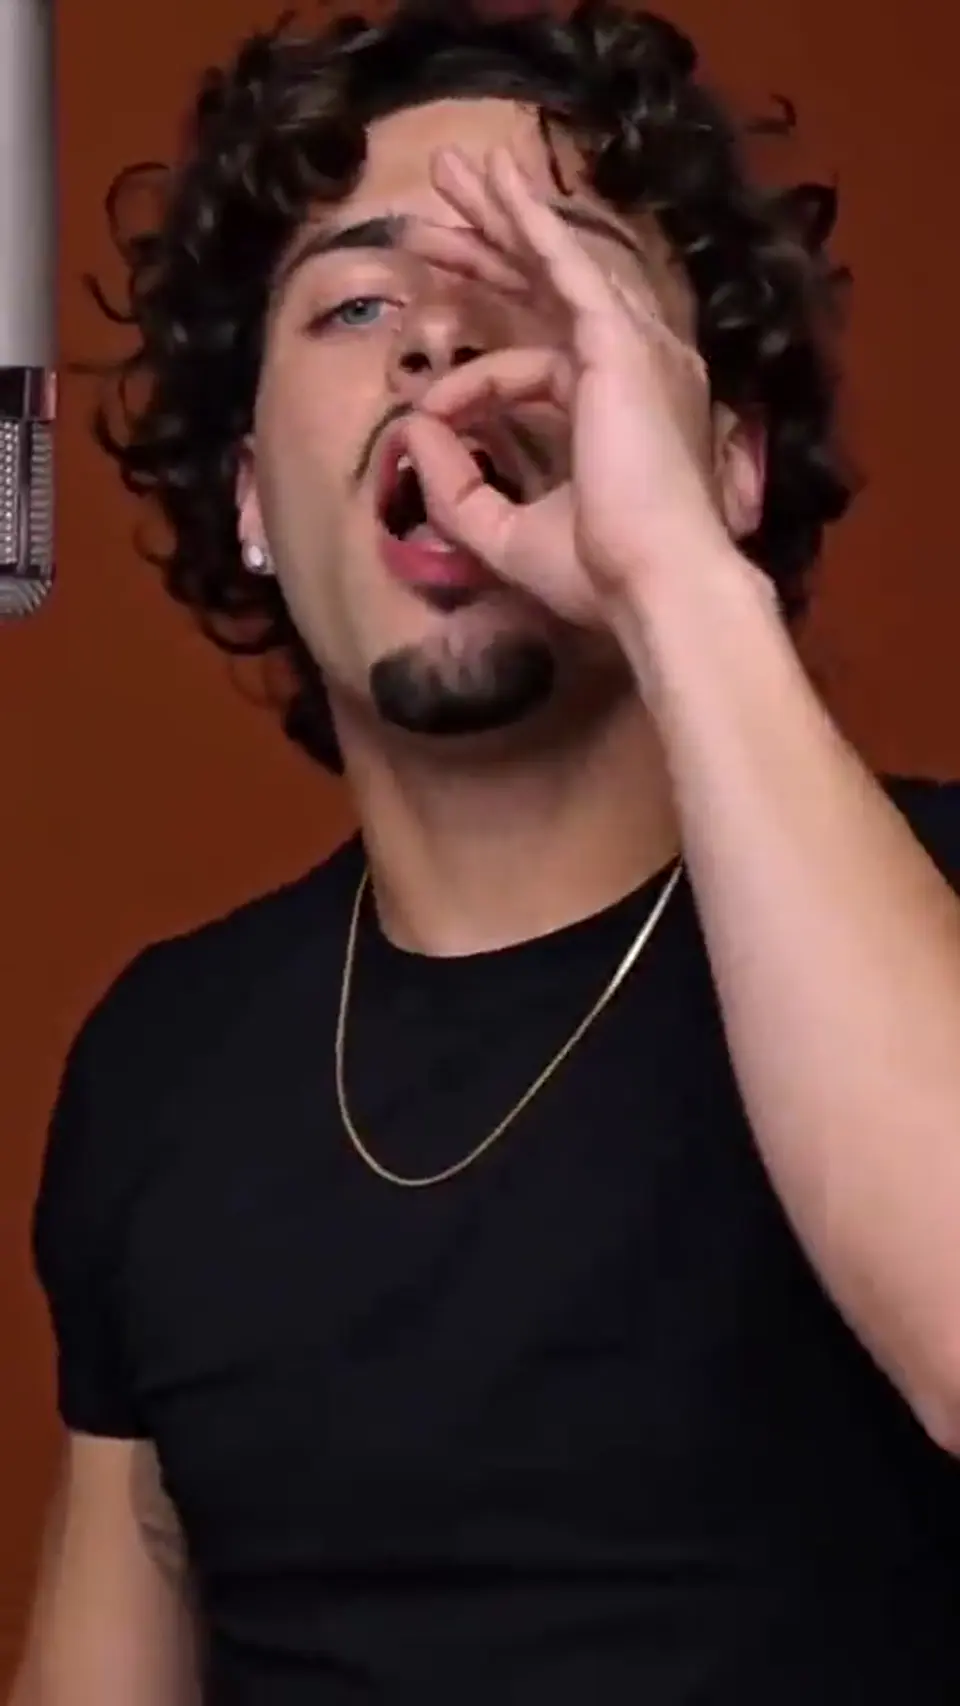
Skull Cap 剪辑的关键,是铺垫和反差发生在同一个房间。一只手盖住镜头,灯光变暗,主体戴着黑色连帽和紧身帽回到画面,表情也完全改变。前后两段都以你的脸作为视觉锚点。
用一张照片制作 10 秒桌前自拍变装:亮场搞怪开头,遮镜转场后换成黑色连帽衫和紧身帽造型。
如何制作 Skull Cap 反差变装视频 视频
选好 竖屏 画幅,上传 1 张照片,剩下的交给预设提示词。
选择 一张照片 效果
以 9:16、720p 渲染,时长 10 秒,适配 TikTok、Reels 与 Shorts。
上传 1 张照片
上传 1 张照片,保证一张清晰的正脸。成片中的穿着、光线和面部细节可能会发生变化。
消耗 10 积分生成
预设的 Skull Cap 反差变装视频 提示词会处理生成——预览后下载即可。
- 单人照片
- 正脸清晰可见
- 光线均匀自然
- 全身或半身照
- 明星照片
- 多人合影
- 墨镜或口罩
- 过小的照片(小于 300 px)
请只上传你有权使用的照片。禁止未成年人、裸露内容,未经同意不得上传他人照片。 · 这个模板需要 1 张照片。
立即开始制作模板预设的 10 秒镜头顺序
这是预设节奏,不是生成成片的录屏。实际时间可能因每次生成而不同。
- 0–3s第 01 段
亮场桌前自拍开场,表情略显搞怪,双手拨动头发。
- 3–5s第 02 段
一只手移到镜头前,遮住节奏转场。
- 5–8s第 03 段
房间变暗,主体调整连帽和紧身帽。
- 8–10s第 04 段
缓慢转头,最后以直接、自信的眼神看向镜头。
输出规格与限制
这个工具实际输出什么,以及哪些地方可能与参考原片不同。
与参考原片的差异
生成结果会尽量跟随参考视频的场景和节奏,但面部、动作、手部和时间点仍可能在不同次生成中有所差异。输出保持 9:16 画幅。
可能出现的问题
- 人物一致性是设计目标,不是保证。不同生成之间脸部可能漂移。
- 成片始终包含来自参考片段的音频;每次生成的混音和音量可能不同。
- TrendVido 是独立产品,与参考原片的权利方以及原片涉及的品牌、活动或人物没有关联,也未获得其背书。
照片要求
- 一张清晰的单人照片。
- 正脸清晰、朝向镜头、光线均匀。不要墨镜、口罩或重滤镜。
- JPG、PNG 或 WebP;每张不超过 10 MB。
- 只上传你本人或已同意出镜的成年人的照片。
价格
每条视频一个价格。开始生成时才扣积分,失败会自动退还。
| 版本 | 照片 | 时长 | 比例 | 分辨率 | 价格 |
|---|---|---|---|---|---|
| 一张照片竖屏 | 1 张照片 | 10 秒 | 9:16 | 720p | 10 积分 |
积分包
一次付费,不会自动续费。10 积分 = 1 条视频,积分永不过期。
发布建议
几个让成片在信息流里表现更好的小技巧。
- 使用不戴帽子和墨镜的正面照,露出发际线、眼睛和下颌,方便把亮场开头与戴帽结尾辨认为同一个人。
- 上传照片保持面部光线均匀,遮镜转场后的暗光由模板生成。
- 重点检查手掌离开镜头后的第一段画面,换上帽子、连帽衫和表情后,脸仍应能辨认。
不用写提示词,也能做视频
场景、镜头顺序和输出规格都已经预设好。
无需写提示词
场景方向已经准备好,你只需要提供照片,不用设计镜头脚本。
价格清楚
生成前就能看到积分价格,只有开始生成时才会扣积分。
流程简单
上传、生成、下载都在同一个浏览器流程里完成,不需要剪辑时间线。
关于这个模板的问题
01照片里需要先戴好紧身帽吗?
更建议不戴帽子的照片。模板会在转场后加入紧身帽和黑色连帽衫,上传图主要用来提供清楚的面部特征。
02Skull Cap 变装是怎样发生的?
先是明亮灯光下的搞怪桌前自拍,手掌盖住镜头后切换到暗光,再以黑色帽子、连帽衫和严肃凝视揭晓,同一房间里的反差构成主要效果。
03会把我的房间换成其他地方吗?
场景说明要求前后都处于同一个桌前自拍环境,变化主要来自灯光、服装和表情,但不保证复刻上传照片的原背景。